
تاخیر در سرور یکی از مهمترین عواملی است که میتواند سرعت سایت، کیفیت اجرای نرمافزار، عملکرد دیتابیس و تجربه کاربران را تحت تأثیر قرار دهد. گاهی یک صفحه دیر باز میشود، پاسخ API با تاخیر در سرور برمیگردد یا اجرای یک درخواست ساده زمان زیادی میبرد. در چنین شرایطی معمولاً اولین تصور این است که سرعت اینترنت یا قدرت سرور پایین است؛ اما علت اصلی همیشه به این دو مورد محدود نمیشود.
ممکن است شبکه سرور وضعیت مناسبی داشته باشد، اما پردازنده با حجم بالایی از درخواستها درگیر شده باشد. در شرایط دیگر، کمبود رم، عملکرد ضعیف فضای ذخیرهسازی، تنظیمات نامناسب سیستمعامل، کدهای غیربهینه یا کوئریهای سنگین دیتابیس باعث افزایش تاخیر در سرور میشوند.
برای کاهش Latency باید ابتدا مشخص شود تأخیر در کدام بخش از مسیر ارتباطی ایجاد شده است. اندازهگیری صرف پینگ برای تشخیص تمام مشکلات کافی نیست؛ زیرا پینگ بیشتر وضعیت رفتوبرگشت بستههای شبکه را نشان میدهد و زمان پردازش برنامه، دیتابیس یا سختافزار را بهطور کامل مشخص نمیکند.
در این راهنما مفهوم Latency یا تاخیر در سرور را از پایه بررسی میکنیم. سپس انواع تاخیر، عوامل شبکهای، نرمافزاری و سختافزاری، روشهای اندازهگیری و راهکارهای کاهش تاخیر در سرور را توضیح خواهیم داد.
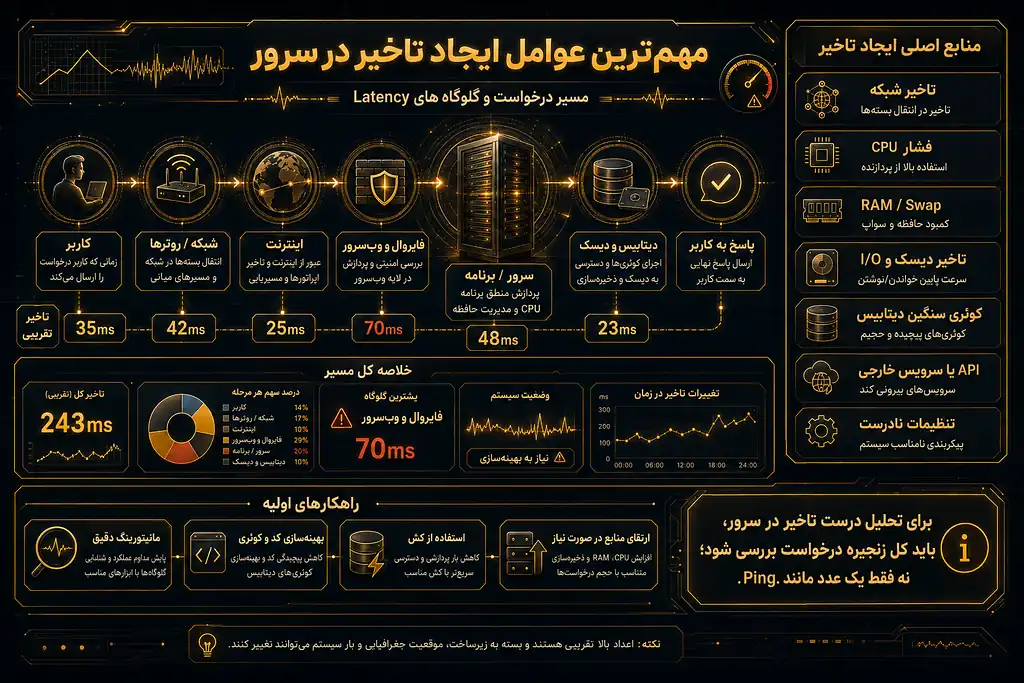
برای پاسخ به سؤال «تاخیر در سرور چیست» باید ابتدا مسیر یک درخواست را بشناسیم. زمانی که کاربر آدرس یک سایت را در مرورگر وارد میکند یا نرمافزاری به یک API متصل میشود، درخواست باید چندین مرحله را پشت سر بگذارد. مدتزمان سپریشده در هر مرحله میتواند بخشی از تاخیر در سرور را تشکیل دهد.
در تعریف ساده، Latency مدتزمانی است که از ارسال یک درخواست تا دریافت پاسخ یا انجام یک عملیات سپری میشود. هرچه این زمان کمتر باشد، سرویس سریعتر و روانتر به نظر میرسد. بااینحال، Latency در سرور فقط به سرعت انتقال اطلاعات در اینترنت وابسته نیست.
بخشی از تأخیر ممکن است هنگام عبور بستهها از تجهیزات شبکه ایجاد شود. بخش دیگری نیز میتواند به زمان لازم برای پردازش درخواست در CPU، خواندن اطلاعات از دیسک، اجرای کد برنامه یا دریافت نتیجه از دیتابیس مربوط باشد.
Latency در سرور را میتوان فاصله زمانی میان شروع یک عملیات و مشاهده نتیجه آن دانست. این عملیات ممکن است دریافت یک فایل، اجرای دستور در دیتابیس، پاسخگویی وبسرور، پردازش یک تراکنش یا برقراری ارتباط میان دو سرویس باشد.
برای مثال، کاربر روی دکمه ورود به حساب کاربری کلیک میکند. درخواست ابتدا از دستگاه کاربر به سمت شبکه ارسال میشود، از چند روتر عبور میکند و به دیتاسنتر میرسد. سپس فایروال و وبسرور درخواست را دریافت میکنند. برنامه اطلاعات ورود را بررسی کرده و برای اعتبارسنجی به دیتابیس متصل میشود. در پایان، پاسخ از همان مسیر به کاربر بازمیگردد.
تاخیر در سرور در هرکدام از این مراحل به زمان نهایی پاسخ اضافه میشود. بنابراین، برای تحلیل درست تاخیر در سرور باید تمام زنجیره درخواست بررسی شود، نه اینکه فقط یک عدد مانند Ping یا سرعت دانلود معیار قرار گیرد.

مسیر پردازش درخواست با تبدیل نام دامنه به آدرس IP آغاز میشود. اگر پاسخ DNS کند باشد، کاربر پیش از برقراری ارتباط با سرور با تأخیر مواجه خواهد شد. پس از آن، بستهها از شبکه ارائهدهنده اینترنت، روترهای میانی و شبکه دیتاسنتر عبور میکنند.
بعد از رسیدن درخواست به زیرساخت مقصد، تجهیزاتی مانند فایروال، سیستم تشخیص نفوذ یا Load Balancer آن را بررسی میکنند. هرکدام از این تجهیزات میتوانند چند میلیثانیه به زمان پاسخ اضافه کنند. در شبکههای شلوغ یا پیکربندیهای غیربهینه، این زمان بیشتر خواهد شد.
در مرحله بعد، سیستمعامل سرور باید اتصال را بپذیرد و درخواست را در اختیار سرویس موردنظر قرار دهد. وبسرورهایی مانند Nginx یا Apache، برنامههای Backend و سرویسهای دیتابیس هرکدام بخشی از عملیات پردازشی را انجام میدهند.
اگر پردازنده درگیر باشد، درخواست در صف پردازش باقی میماند. اگر رم کافی وجود نداشته باشد، سیستم ممکن است از فضای Swap استفاده کند که معمولاً بسیار کندتر از RAM است. همچنین اگر دیسک با تعداد زیادی عملیات خواندن و نوشتن مواجه باشد، افزایش صف I/O باعث بیشترشدن تاخیر در سرور خواهد شد.
یکی از خطاهای رایج در عیبیابی، یکسان دانستن تاخیر در سرور با پینگ بالا است. ممکن است پینگ یک سرور مناسب باشد، اما سایت یا نرمافزار همچنان کند پاسخ دهد. در چنین وضعیتی، بسته شبکه سریع به سرور رسیده است، ولی پردازش داخلی درخواست زمان زیادی مصرف میکند.
برای نمونه، یک کوئری دیتابیس که فاقد ایندکس مناسب است ممکن است چند ثانیه زمان نیاز داشته باشد. در این شرایط، کاهش فاصله جغرافیایی یا افزایش پهنای باند تأثیر قابلتوجهی ایجاد نمیکند. ابتدا باید ساختار دیتابیس و نحوه اجرای کوئری اصلاح شود.
حالت عکس نیز امکانپذیر است. ممکن است سرور از پردازنده قدرتمند، رم کافی و فضای ذخیرهسازی سریع استفاده کند، اما فاصله زیاد کاربر تا دیتاسنتر یا Packet Loss در مسیر شبکه باعث افزایش Latency شود. در این حالت، ارتقای سختافزار بهتنهایی تاخیر در سرور را کاهش نمیدهد.
تاخیر در سرور یک معیار واحد با علت مشخص نیست. این تأخیر میتواند در شبکه، تجهیزات ارتباطی، سیستمعامل، سختافزار، برنامه، دیتابیس یا معماری سرویس ایجاد شود. تفکیک انواع Latency کمک میکند منبع گلوگاه سریعتر شناسایی شود.
تاخیر شبکه مدتزمانی است که داده برای حرکت از مبدأ به مقصد نیاز دارد. فاصله جغرافیایی، تعداد روترهای میانی، کیفیت مسیر، ازدحام شبکه، از دست رفتن بستهها و پردازش تجهیزات امنیتی از عوامل مؤثر بر Network Latency هستند.
فاصله دیتاسنتر با کاربران اهمیت زیادی دارد. حتی در شبکهای با تجهیزات مناسب، داده برای طیکردن فاصله فیزیکی به زمان نیاز دارد. به همین دلیل، استفاده از دیتاسنتر نزدیک به کاربران یا شبکه توزیع محتوا میتواند بخشی از تاخیر در سرور را کاهش دهد.
تاخیر انتشار به زمانی مربوط است که سیگنال برای پیمودن فاصله فیزیکی نیاز دارد. تاخیر انتقال نیز مدتزمان لازم برای قراردادن داده روی بستر ارتباطی است. هرچه حجم بسته بیشتر یا ظرفیت لینک کمتر باشد، این زمان میتواند افزایش پیدا کند.
تاخیر صف زمانی ایجاد میشود که بستهها پیش از ارسال یا پردازش منتظر بمانند. در ساعات پرترافیک، صف تجهیزات شبکه طولانیتر میشود. تاخیر پردازش بسته نیز به زمانی مربوط است که روتر، فایروال یا سوییچ برای بررسی مقصد و تصمیمگیری درباره بسته نیاز دارد.
تاخیر پردازشی زمانی رخ میدهد که سیستم برای اجرای درخواست به زمان بیشتری نیاز داشته باشد. مصرف بالای CPU، تعداد زیاد پردازشهای همزمان، تنظیم نامناسب تعداد Workerها و اجرای عملیات سنگین میتواند زمان انتظار را افزایش دهد.
در سرورهایی که چند سرویس بهطور همزمان اجرا میشوند، یک برنامه پرمصرف ممکن است منابع سایر سرویسها را محدود کند. در چنین شرایطی، حتی درخواستهای سبک نیز باید در صف بمانند و تاخیر در سرور افزایش پیدا میکند.
تاخیر سخت افزار به محدودیت یا عملکرد نامناسب قطعاتی مانند پردازنده، رم، دیسک، کنترلر ذخیرهسازی و کارت شبکه مربوط است. این نوع Latency همیشه به معنی خرابی قطعه نیست. گاهی سختافزار سالم است، اما توان آن با حجم کاری فعلی تناسب ندارد.
برای مثال، پردازندهای با تعداد هسته کم ممکن است در برابر درخواستهای همزمان اشباع شود. کمبود RAM میتواند سیستم را به استفاده از Swap مجبور کند. هارددیسک مکانیکی نیز در پردازش عملیات تصادفی معمولاً تاخیر بیشتری نسبت به SSD یا NVMe دارد.
پیکربندی نامناسب سیستمعامل، سرویسهای غیرضروری، محدودیت تعداد اتصال، مدیریت ضعیف Threadها و بهروزبودن نبودن درایورها ممکن است باعث تاخیر در سرور شوند. در لایه برنامه نیز الگوریتمهای ناکارآمد، حلقههای پردازشی سنگین و تماسهای متعدد با سرویسهای خارجی زمان پاسخ را افزایش میدهند.
دیتابیس یکی از متداولترین منابع Latency در سرویسهای تحت وب است. نبود ایندکس مناسب، کوئریهای پیچیده، قفلشدن جدولها، تعداد بالای اتصال و خواندن حجم زیادی از داده میتواند پاسخگویی را کند کند.
عملکرد فضای ذخیرهسازی نیز مستقیماً بر دیتابیس و برنامه تأثیر میگذارد. اگر تعداد درخواستهای ورودی بیشتر از توان دیسک باشد، عملیات در صف قرار میگیرند. افزایش I/O Wait یکی از نشانههایی است که باید هنگام بررسی تاخیر در سرور مورد توجه قرار گیرد.
در سرور مجازی، منابع فیزیکی میان چند ماشین تقسیم میشوند. اگر میزبان اصلی بیش از ظرفیت بارگذاری شده باشد، ماشین مجازی ممکن است برای دریافت زمان پردازنده منتظر بماند. این وضعیت معمولاً با معیاری مانند CPU Steal قابل بررسی است.
در زیرساخت ابری نیز ارتباط میان سرویسها، مناطق جغرافیایی مختلف، فضای ذخیرهسازی شبکهای و APIهای خارجی ممکن است Latency ایجاد کند. به همین دلیل، طراحی معماری و محل استقرار سرویسها بهاندازه قدرت یک سرور اهمیت دارد.
| نوع تأخیر | محل ایجاد | نشانه رایج | معیار یا ابزار تشخیص | اقدام اولیه |
|---|---|---|---|---|
| تاخیر شبکه | مسیر میان کاربر و دیتاسنتر | پینگ بالا یا نوسان ارتباط | Ping، MTR و Traceroute | بررسی مسیر، Packet Loss و فاصله دیتاسنتر |
| تاخیر پردازنده | CPU و صف پردازش | کندی در زمان افزایش درخواستها | CPU Usage و Load Average | شناسایی پردازش پرمصرف و مدیریت بار |
| تاخیر رم | حافظه و Swap | کندی تدریجی و فعالیت زیاد دیسک | Memory Usage، Swap و vmstat | کاهش مصرف حافظه یا افزایش RAM |
| تاخیر ذخیرهسازی | هارد، SSD یا کنترلر RAID | کندی دیتابیس و عملیات فایل | I/O Wait، IOPS و Disk Queue | بررسی سلامت، صف دیسک و نوع ذخیرهساز |
| تاخیر برنامه | کد، وبسرور و API | کندی یک صفحه یا عملیات خاص | APM، Log و Profiling | شناسایی تابع یا درخواست پرهزینه |
| تاخیر دیتابیس | کوئری، ایندکس و قفلها | پاسخ دیرهنگام صفحات دادهمحور | Slow Query Log و Execution Plan | بهینهسازی کوئری و ایندکسگذاری |
برای عیبیابی دقیق تاخیر در سرور باید تفاوت Latency با معیارهایی مانند Ping، RTT، Jitter، TTFB، پهنای باند و Throughput مشخص باشد. استفاده اشتباه از این اصطلاحات ممکن است نتیجه بررسی را منحرف کند.
Latency مفهوم کلی زمان تأخیر است، اما Ping ابزاری برای اندازهگیری زمان رفتوبرگشت بسته میان دو نقطه محسوب میشود. پایینبودن Ping نشان میدهد مسیر شبکه سریع است، ولی تضمین نمیکند برنامه یا دیتابیس نیز سریع پاسخ دهد.
RTT مدتزمان رفت درخواست و بازگشت پاسخ را نشان میدهد. Jitter نیز میزان تغییر و نوسان زمان تأخیر میان بستههای متوالی است. ممکن است میانگین Latency مناسب باشد، اما نوسان شدید آن باعث اختلال در تماس اینترنتی، استریم و سرویسهای بلادرنگ شود.
TTFB مدتزمان میان ارسال درخواست تا دریافت اولین بایت پاسخ از سرور است. این معیار علاوه بر زمان شبکه، میتواند تحت تأثیر پردازش Backend، وبسرور و دیتابیس قرار گیرد. بنابراین، TTFB بالا نشانهای مهم است، اما بهتنهایی علت دقیق تاخیر در سرور را مشخص نمیکند.
پهنای باند ظرفیت نظری یک ارتباط برای انتقال داده است. Throughput حجم واقعی دادهای است که در یک بازه زمانی منتقل میشود. Latency نیز مدتزمان لازم برای شروع یا تکمیل انتقال و دریافت پاسخ را بیان میکند.
یک شبکه میتواند پهنای باند بالایی داشته باشد، اما به دلیل فاصله زیاد یا مسیر نامناسب با Latency بالا مواجه شود. از سوی دیگر، یک ارتباط کمتأخیر ممکن است ظرفیت محدودی برای انتقال فایلهای حجیم داشته باشد. به همین دلیل، برای بررسی تاخیر در سرور باید این معیارها جداگانه تحلیل شوند.
افزایش تاخیر در سرور معمولاً نتیجه یک عامل واحد نیست. ممکن است چند گلوگاه بهصورت همزمان در شبکه، سختافزار، سیستمعامل، برنامه و دیتابیس وجود داشته باشند. به همین دلیل، پیش از ارتقای منابع باید علت واقعی کندی مشخص شود.
هرچه فاصله میان کاربر و دیتاسنتر بیشتر باشد، بستههای اطلاعاتی مسیر طولانیتری را طی میکنند. این موضوع حتی در شبکههای پرسرعت نیز مقدار مشخصی Latency ایجاد میکند. تعداد تجهیزات و مسیرهای میانی نیز بر زمان رفتوبرگشت داده اثر میگذارد.
اگر بیشتر کاربران یک سایت داخل ایران باشند، استفاده از سروری در موقعیت جغرافیایی بسیار دور میتواند تاخیر در سرور را افزایش دهد. انتخاب دیتاسنتر نزدیکتر یا استفاده از CDN برای محتوای ثابت، زمان دسترسی کاربران را کاهش میدهد.
ازدحام شبکه زمانی رخ میدهد که حجم ترافیک از ظرفیت یک لینک یا تجهیز بیشتر شود. در این شرایط، بستهها در صف قرار میگیرند یا از بین میروند. بستههای ازدسترفته باید دوباره ارسال شوند و همین فرایند زمان پاسخ را افزایش میدهد.
Packet Loss، نوسان شدید پینگ و افزایش ناگهانی RTT میتوانند نشانه مشکل در مسیر ارتباطی باشند. استفاده از MTR و Traceroute کمک میکند مشخص شود افزایش تاخیر در کدام بخش مسیر اتفاق میافتد.
پردازنده مسئول اجرای دستورهای سیستمعامل، برنامه و سرویسهای سرور است. اگر مصرف CPU برای مدت طولانی نزدیک به ظرفیت کامل باقی بماند، درخواستهای جدید باید منتظر آزادشدن منابع بمانند.
افزایش Load Average، تعداد زیاد پردازشهای فعال و زمان انتظار طولانی میتواند نشانه اشباع پردازنده باشد. بااینحال، مشاهده مصرف بالای CPU بهتنهایی برای تصمیمگیری درباره ارتقای سختافزار کافی نیست. ابتدا باید پردازش پرمصرف و دلیل اجرای آن بررسی شود.
زمانی که حافظه RAM کافی نباشد، سیستمعامل ممکن است بخشی از دادهها را به Swap منتقل کند. ازآنجاکه فضای ذخیرهسازی نسبت به RAM سرعت کمتری دارد، دسترسی مکرر به Swap میتواند تاخیر در سرور را به شکل محسوسی افزایش دهد.
کمبود حافظه ممکن است باعث بستهشدن پردازشها، کندی دیتابیس یا کاهش سرعت پاسخگویی وبسرور شود. بررسی Memory Usage، مقدار Swap مصرفشده و نرخ جابهجایی داده میان RAM و دیسک برای تشخیص این وضعیت ضروری است.
فضای ذخیرهسازی یکی از مهمترین عوامل تاخیر سخت افزار است. هارددیسکهای مکانیکی در عملیات تصادفی و پردازش تعداد زیادی درخواست همزمان، معمولاً عملکرد ضعیفتری نسبت به SSD و NVMe دارند.
نوع RAID، حافظه کش کنترلر، سلامت دیسکها و تعداد عملیات خواندن و نوشتن نیز بر Latency تأثیر میگذارند. افزایش I/O Wait یا طولانیشدن Disk Queue نشان میدهد پردازنده برای دریافت داده از ذخیرهساز منتظر مانده است.
کارت شبکه، درایور، سرعت پورت، حالت Duplex و تنظیمات Offloading میتوانند بر عملکرد ارتباطی سرور اثر بگذارند. ناسازگاری درایور یا تنظیم نادرست Duplex ممکن است باعث Packet Loss، خطاهای شبکه و کاهش Throughput شود.
در چنین شرایطی، افزایش پهنای باند سرویس لزوماً مشکل را حل نمیکند. ابتدا باید خطاهای Interface، وضعیت لینک و هماهنگی تنظیمات کارت شبکه با سوییچ بررسی شود.
گاهی منابع سختافزاری سرور مناسب هستند، اما کد برنامه عملیات غیرضروری زیادی انجام میدهد. فراخوانی مکرر APIهای خارجی، پردازش فایلهای بزرگ، اجرای حلقههای سنگین و ایجاد اتصالهای متعدد میتواند زمان پاسخ را افزایش دهد.
اگر فقط یک صفحه یا عملیات مشخص کند باشد، احتمال وجود گلوگاه در لایه برنامه بیشتر است. ابزارهای APM و Profiling میتوانند مدت اجرای هر تابع، درخواست خارجی و عملیات دیتابیس را نشان دهند.
نبود ایندکس مناسب، اسکن کامل جدول، بازیابی دادههای غیرضروری و اجرای همزمان تراکنشهای سنگین از عوامل رایج افزایش تاخیر در سرور هستند. قفلشدن رکوردها یا جدولها نیز ممکن است سایر درخواستها را در صف انتظار قرار دهد.
Slow Query Log و Execution Plan برای شناسایی کوئریهای پرهزینه کاربرد دارند. بهینهسازی دیتابیس باید بر اساس دادههای واقعی انجام شود؛ زیرا ایجاد تعداد زیاد ایندکس نیز میتواند عملیات نوشتن را کند کند.
افزایش ناگهانی تعداد کاربران، حملات مخرب یا اجرای کمپین تبلیغاتی ممکن است تعداد درخواستها را بیشتر از ظرفیت فعلی سرور کند. در این شرایط، CPU، RAM، وبسرور یا دیتابیس به گلوگاه تبدیل میشوند.
محدودکردن درخواستهای غیرعادی، استفاده از Cache، تنظیم مناسب Workerها و توزیع ترافیک میان چند سرور میتواند از افزایش شدید Latency جلوگیری کند.
در سرور مجازی، منابع پردازنده و ذخیرهسازی میان چند ماشین تقسیم میشوند. اگر میزبان فیزیکی بیش از ظرفیت واقعی بارگذاری شده باشد، ماشین مجازی برای دسترسی به پردازنده منتظر میماند.
بالابودن CPU Steal میتواند نشانه رقابت ماشینهای مجازی بر سر منابع پردازشی باشد. در چنین وضعیتی، بهینهسازی داخل سیستمعامل همیشه کافی نیست و ممکن است انتقال سرویس به میزبان خلوتتر یا سرور اختصاصی لازم باشد.
برای کاهش تاخیر در سرور باید اندازهگیری از بیرون و داخل زیرساخت بهصورت همزمان انجام شود. ابتدا مشخص کنید کندی برای همه کاربران رخ میدهد یا فقط یک منطقه، سرویس یا عملیات خاص را درگیر کرده است.
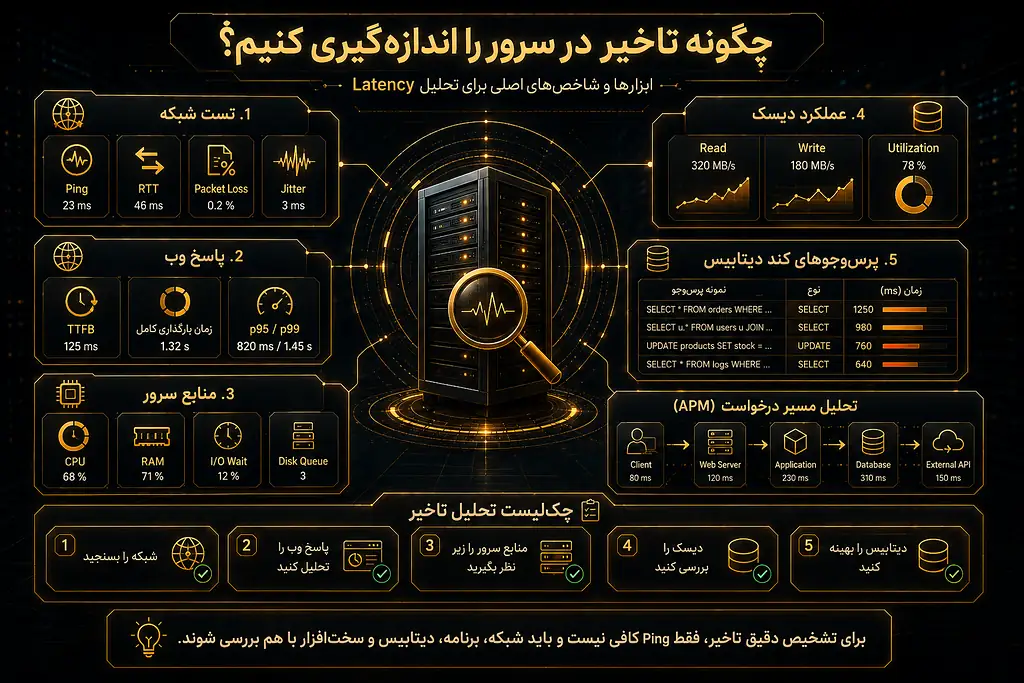
اگر هدف بررسی مسیر شبکه است، معیارهایی مانند Ping، RTT، Packet Loss و Jitter اهمیت دارند. برای ارزیابی پاسخ وبسرور باید TTFB و زمان کامل درخواست بررسی شود. در داخل سرور نیز مصرف CPU، حافظه، I/O Wait، صف دیسک و زمان اجرای کوئریها معیارهای اصلی هستند.
اندازهگیری فقط میانگین Latency میتواند گمراهکننده باشد. ممکن است بیشتر درخواستها سریع باشند، اما درصد کوچکی از آنها با تأخیر بسیار بالا پاسخ داده شوند. به همین دلیل، بررسی شاخصهایی مانند p95 و p99 برای سرویسهای پرترافیک مفید است.
ابزار Ping زمان رفتوبرگشت بسته را اندازهگیری میکند. Traceroute مسیر عبور داده را نشان میدهد و MTR اطلاعات مسیر را با میزان Packet Loss و زمان پاسخ ترکیب میکند. برای نتیجه دقیقتر بهتر است تست از چند موقعیت جغرافیایی انجام شود.
یک Hop با زمان پاسخ بالا همیشه به معنی وجود مشکل نیست؛ زیرا برخی روترها پاسخ ICMP را در اولویت پایین قرار میدهند. زمانی میتوان به یک بخش از مسیر مشکوک شد که افزایش تأخیر یا Packet Loss در Hopهای بعدی نیز ادامه پیدا کند.
در سیستمهای لینوکسی ابزارهایی مانند:
برای مشاهده وضعیت منابع کاربرد دارند. این ابزارها مصرف پردازنده، حافظه، Swap، I/O Wait و عملکرد ذخیرهسازی را نمایش میدهند.
برای تشخیص تاخیر سخت افزار باید وضعیت در یک بازه زمانی بررسی شود. یک نمونه کوتاه ممکن است گلوگاههایی را که فقط در ساعات پرترافیک رخ میدهند نشان ندهد. ذخیرهسازی دادههای مانیتورینگ امکان مقایسه وضعیت عادی و زمان بروز مشکل را فراهم میکند.برای خرید رم سرور اچ پی به سایت ما مراجعه کنید.
ابزار APM مسیر اجرای درخواست را از وبسرور تا برنامه، دیتابیس و سرویسهای خارجی ثبت میکند. با این روش میتوان مشخص کرد کدام مرحله بیشترین سهم را در تاخیر در سرور دارد.
برای دیتابیس نیز باید زمان اجرای کوئری، تعداد رکوردهای بررسیشده، وضعیت ایندکسها و قفلها تحلیل شود. اگر بخش بزرگی از زمان درخواست در دیتابیس مصرف شود، ارتقای CPU وبسرور احتمالاً نتیجه مطلوبی ایجاد نمیکند.
اگر Ping و MTR وضعیت مناسبی دارند، اما TTFB بالا است، احتمال وجود مشکل در پردازش داخلی سرور، برنامه یا دیتابیس بیشتر میشود. اگر TTFB از داخل دیتاسنتر مناسب ولی از موقعیت کاربران بالا باشد، مسیر شبکه یا فاصله جغرافیایی باید بررسی شود.
| علامت مشاهدهشده | عامل احتمالی | ابزار بررسی | اقدام پیشنهادی |
|---|---|---|---|
| پینگ بالا برای بیشتر کاربران | فاصله زیاد یا مسیر نامناسب شبکه | Ping، MTR و Traceroute | بررسی مسیر، دیتاسنتر نزدیکتر یا CDN |
| پینگ مناسب و TTFB بالا | کندی برنامه، وبسرور یا دیتابیس | curl، APM و گزارش وبسرور | تحلیل زمان پردازش درخواست |
| کندی هنگام افزایش ترافیک | اشباع CPU، RAM یا Workerها | top، vmstat و Load Average | بهینهسازی منابع و کنترل همزمانی |
| I/O Wait و صف دیسک بالا | گلوگاه ذخیرهسازی | iostat و ابزار مانیتورینگ RAID | کاهش عملیات I/O یا ارتقای ذخیرهساز |
| کندی فقط در صفحات دادهمحور | کوئری سنگین یا قفل دیتابیس | Slow Query Log و Execution Plan | اصلاح کوئری و ایندکسها |
| عملکرد ناپایدار سرور مجازی | رقابت منابع یا CPU Steal | vmstat و دادههای Hypervisor | انتقال به میزبان مناسبتر |
بهترین روش عیبیابی، مقایسه همزمان دادههای شبکه، سیستمعامل، برنامه و دیتابیس است. این رویکرد مانع از آن میشود که برای رفع تاخیر در سرور، منابعی ارتقا داده شوند که در واقع گلوگاه اصلی نیستند.“`html
کاهش تاخیر در سرور باید بر اساس گلوگاه واقعی انجام شود. افزایش منابع بدون بررسی دادههای مانیتورینگ ممکن است هزینه زیرساخت را بالا ببرد، اما تأثیر محسوسی بر سرعت پاسخگویی نداشته باشد. ابتدا باید مشخص شود بیشترین زمان در شبکه، پردازنده، حافظه، ذخیرهساز، برنامه یا دیتابیس مصرف میشود.
نزدیکبودن دیتاسنتر به محل کاربران، زمان رفتوبرگشت بستهها را کاهش میدهد. اگر کاربران از مناطق مختلف به سرویس متصل میشوند، CDN میتواند فایلهای ثابت مانند تصاویر، فایلهای CSS و JavaScript را از نزدیکترین نقطه در اختیار آنها قرار دهد.
CDN معمولاً زمان انتقال محتوا را کاهش میدهد، اما مشکلات پردازشی داخل سرور را برطرف نمیکند. اگر TTFB به دلیل اجرای کند برنامه یا دیتابیس بالا باشد، باید لایه Backend نیز جداگانه بهینه شود.
وجود Packet Loss باعث ارسال مجدد بستهها و افزایش تاخیر در سرور میشود. بررسی کابلها، پورتهای شبکه، تنظیمات کارت شبکه، فایروال، مسیرهای ارتباطی و ظرفیت لینک میتواند به شناسایی علت کمک کند.
در سرویسهایی که ارتباط پایدار اهمیت زیادی دارد، فقط میانگین Ping نباید معیار باشد. میزان Jitter و Packet Loss نیز باید در بازههای پرترافیک بررسی شود.
ارتقای سختافزار زمانی مؤثر است که دادههای مانیتورینگ وجود گلوگاه را تأیید کنند. مصرف مداوم پردازنده، استفاده گسترده از Swap یا صف طولانی دیسک، هرکدام به راهکار متفاوتی نیاز دارند.
اگر پردازنده در ساعات پرترافیک بهطور مداوم اشباع میشود و درخواستها در صف قرار میگیرند، ارتقای CPU میتواند مفید باشد. پیش از این کار باید پردازشهای غیرضروری، تعداد Workerها و کارایی کد بررسی شوند.
در انتخاب پردازنده فقط فرکانس اهمیت ندارد. تعداد هسته، حافظه Cache و تناسب معماری پردازنده با نوع بار کاری نیز باید در نظر گرفته شود. برای بررسی دقیقتر میتوان به راهنمای انتخاب پردازنده مناسب برای سرور مراجعه کرد.
افزایش RAM زمانی به کاهش تاخیر در سرور کمک میکند که کمبود حافظه باعث استفاده از Swap، بستهشدن پردازشها یا محدودشدن Cache شده باشد. اگر مقدار زیادی حافظه آزاد وجود دارد، افزودن RAM احتمالاً تغییر مهمی ایجاد نمیکند.
ظرفیت، فرکانس، نوع ماژول و سازگاری رم با سرور باید همزمان بررسی شوند. مطلب تأثیر رم سرور بر عملکرد سیستم میتواند در انتخاب ظرفیت مناسب کمککننده باشد.
در برنامههایی که عملیات خواندن و نوشتن زیادی دارند، استفاده از SSD یا NVMe میتواند زمان دسترسی به داده را کاهش دهد. این موضوع در دیتابیسها، مجازیسازی و پردازش فایلهای متعدد اهمیت بیشتری دارد.
بااینحال، نوع ذخیرهساز باید متناسب با حجم کاری، ظرفیت، دوام نوشتن و ساختار RAID انتخاب شود. مقایسه هارد SAS، SSD و NVMe سرور انتخاب گزینه مناسب را سادهتر میکند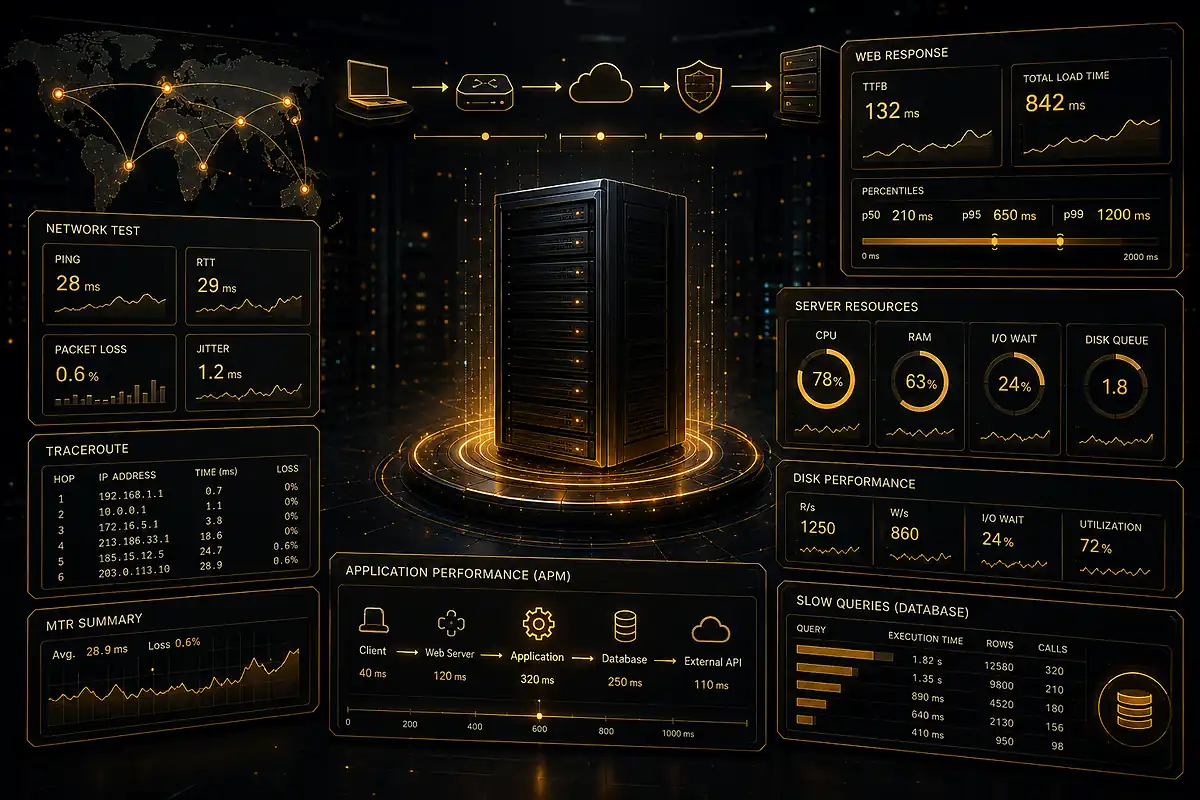
سرویسهای غیرضروری میتوانند پردازنده، حافظه و عملیات دیسک را درگیر کنند. بررسی پردازشهای فعال، محدودیت تعداد فایلهای باز، تنظیمات شبکه و بهروزرسانی درایورها بخشی از بهینهسازی سیستمعامل است.
تغییر تنظیمات Kernel یا شبکه باید با احتیاط انجام شود. تنظیمی که برای یک وبسرور پرترافیک مناسب است، ممکن است برای دیتابیس یا سرویس ذخیرهسازی نتیجه متفاوتی داشته باشد.
Cache تعداد عملیات تکراری را کاهش میدهد. ذخیره پاسخ صفحات، دادههای پرتکرار دیتابیس یا نتیجه محاسبات سنگین میتواند فشار روی CPU و فضای ذخیرهسازی را کمتر کند.
کش باید در لایه مناسب و با زمان انقضای منطقی پیادهسازی شود. نگهداری اطلاعات قدیمی یا پاکنشدن صحیح Cache میتواند باعث نمایش داده نادرست شود.
تنظیم تعداد Workerها، Keep-Alive، فشردهسازی پاسخ و محدودکردن درخواستهای غیرضروری میتواند عملکرد وبسرور را بهبود دهد. در سطح برنامه نیز باید توابع پرهزینه و تماسهای متعدد با APIهای خارجی شناسایی شوند.
عملیات زمانبر مانند تولید گزارش، پردازش تصویر یا ارسال گروهی پیام بهتر است در صفهای پسزمینه اجرا شوند. این روش مانع از آن میشود که کاربر تا پایان تمام پردازشها منتظر بماند.
ایجاد ایندکس مناسب، محدودکردن دادههای بازیابیشده و بازنویسی کوئریهای سنگین میتواند زمان پاسخ دیتابیس را کاهش دهد. Execution Plan نیز نشان میدهد دیتابیس برای اجرای هر کوئری چه مسیری را طی میکند.
Connection Pool از ایجاد مکرر اتصال جدید جلوگیری میکند. بااینحال، تعداد اتصالها نباید بیشتر از ظرفیت دیتابیس تعیین شود؛ زیرا اتصالهای زیاد نیز مصرف حافظه و رقابت منابع را افزایش میدهند.
اگر یک سرور توان پاسخگویی به حجم ترافیک را ندارد، Load Balancer میتواند درخواستها را میان چند سرور توزیع کند. این روش احتمال تشکیل صف طولانی در یک سیستم را کاهش میدهد.
مقیاسپذیری افقی نیازمند هماهنگی Sessionها، فایلهای مشترک، دیتابیس و Cache است. افزودن چند سرور بدون طراحی صحیح معماری ممکن است پیچیدگی و حتی Latency بیشتری ایجاد کند.
برای مدیریت تاخیر در سرور باید وضعیت عادی سیستم مشخص باشد. ثبت معیارهایی مانند RTT، TTFB، مصرف CPU، حافظه، I/O Wait و زمان پاسخ دیتابیس امکان مقایسه شرایط طبیعی با زمان بروز اختلال را فراهم میکند.
هشدارها نیز باید بر اساس رفتار معمول سرویس تنظیم شوند. هشدار بسیار حساس باعث ایجاد اعلانهای غیرضروری میشود و هشدار دیرهنگام ممکن است پس از اختلال جدی فعال شود.
هنگام مشاهده کندی، ابتدا زمان شروع مشکل و سرویسهای درگیر ثبت شود. سپس وضعیت شبکه، منابع سرور، گزارش خطاها، برنامه و دیتابیس در همان بازه زمانی بررسی شود.
اگر مشکل فقط برای کاربران یک منطقه رخ میدهد، مسیر شبکه و موقعیت دیتاسنتر اهمیت بیشتری دارد. اگر همه کاربران همزمان با کندی مواجه هستند، احتمال اشباع منابع یا اختلال در سرویسهای مرکزی بیشتر است.
پینگ مناسب همراه با TTFB بالا معمولاً توجه را به سمت وبسرور، برنامه یا دیتابیس هدایت میکند. افزایش I/O Wait نیز نشان میدهد ذخیرهساز یا حجم عملیات دیسک باید بررسی شود.
ارتقای سختافزار زمانی منطقی است که گلوگاه بهطور تکرارشونده ثبت شود و بهینهسازی نرمافزاری نتواند ظرفیت موردنیاز را فراهم کند. اشباع دائمی CPU، استفاده مداوم از Swap و صف بالای دیسک نمونههایی از این وضعیت هستند.
اگر مسیر شبکه دائماً ناپایدار است، Packet Loss تکرار میشود یا منابع سرور مجازی به دلیل ازدحام میزبان عملکرد ثابتی ندارند، تغییر سرویس میزبانی میتواند بررسی شود.
قبل از انتقال باید چند آزمایش در ساعات و موقعیتهای مختلف انجام شود. جابهجایی شتابزده ممکن است هزینه ایجاد کند، بدون اینکه علت اصلی تاخیر در سرور برطرف شود.
تاخیر در سرور میتواند در شبکه، پردازنده، حافظه، ذخیرهساز، سیستمعامل، برنامه یا دیتابیس ایجاد شود. به همین دلیل، Ping پایین بهتنهایی به معنی عملکرد مناسب تمام بخشهای سرور نیست.
برای کاهش تاخیر در سرور باید معیارهای شبکه و منابع داخلی همزمان بررسی شوند. ابزارهایی مانند MTR، iostat، vmstat، APM و Slow Query Log کمک میکنند محل اصلی اتلاف زمان مشخص شود.
پس از شناسایی گلوگاه میتوان راهکار مناسب را انتخاب کرد؛ از اصلاح مسیر شبکه و فعالسازی Cache گرفته تا بهینهسازی دیتابیس یا ارتقای قطعات. تصمیمگیری بر اساس داده، هزینههای غیرضروری را کاهش میدهد و پایداری بیشتری ایجاد میکند.
اگر تاخیر در سرور بهصورت مداوم تکرار میشود، بهتر است پیش از خرید قطعه یا تغییر سرویس، گزارش کاملی از مصرف منابع و زمان پاسخ تهیه شود. این گزارش مشخص میکند کدام اقدام بیشترین تأثیر را بر بهبود عملکرد خواهد داشت.
تخفیف برای محصولات منتخب. فرصت را از دست ندهید!
تاخیر در سرور مدتزمانی است که از ارسال درخواست تا پردازش و دریافت پاسخ سپری میشود. این زمان میتواند شامل تأخیر شبکه، پردازش CPU، دسترسی به دیسک، اجرای برنامه و پاسخ دیتابیس باشد. افزایش هرکدام از این مراحل باعث کندترشدن سرویس میشود.
عدد مناسب به نوع سرویس، فاصله جغرافیایی و نیاز کاربران بستگی دارد. سرویسهای بلادرنگ مانند تماس صوتی و بازی آنلاین به Latency پایینتری نیاز دارند. بهتر است علاوه بر میانگین، نوسان تأخیر و شاخصهایی مانند p95 نیز بررسی شوند.
Ping زمان رفتوبرگشت بسته در شبکه را اندازهگیری میکند، اما تاخیر در سرور مفهوم گستردهتری دارد. ممکن است Ping پایین باشد، ولی برنامه یا دیتابیس چند ثانیه برای پردازش درخواست زمان نیاز داشته باشد. بنابراین، پینگ فقط یکی از معیارهای عیبیابی است.
افزایش RAM زمانی مؤثر است که حافظه فعلی کافی نباشد و سیستم از Swap استفاده کند. اگر حافظه آزاد کافی وجود داشته باشد، افزودن RAM الزاماً سرعت را افزایش نمیدهد. پیش از ارتقا باید مصرف حافظه و رفتار برنامهها بررسی شود.
برای شبکه باید Ping، RTT، Packet Loss و مسیر ارتباطی بررسی شود. در داخل سرور نیز مصرف CPU، مقدار Swap، I/O Wait و صف دیسک اهمیت دارند. مقایسه این دادهها مشخص میکند تأخیر پیش از رسیدن درخواست یا هنگام پردازش ایجاد شده است.
TTFB زمان دریافت اولین بایت پاسخ را نشان میدهد و میتواند تحت تأثیر شبکه، وبسرور، برنامه و دیتابیس باشد. TTFB بالا یک نشانه مهم از کندی است، اما علت دقیق را تعیین نمیکند. برای تشخیص نهایی باید اجزای درخواست جداگانه اندازهگیری شوند.
اگر گلوگاه اصلی مربوط به خواندن و نوشتن داده باشد، SSD و NVMe میتوانند Latency را کاهش دهند. این تأثیر در دیتابیسها و محیطهای مجازی بیشتر دیده میشود. اگر مشکل از شبکه یا کد برنامه باشد، تعویض دیسک نتیجه محدودی خواهد داشت.


